Dil modellerinde güvenlik hizalaması (alignment), yani modelin zararlı bir isteğe “bu konuda yardımcı olamam” diye cevap vermesi, eğitim sırasında modele kazandırılır. Bunun için insan geri bildirimiyle pekiştirmeli öğrenme (RLHF) veya tercih çiftleriyle doğrudan optimizasyon (DPO) gibi fine-tuning yöntemleri kullanılır. 2024’e kadar bu davranışı aşmak isteyen biri ya her istekte jailbreak prompt’larıyla uğraşıyor ya da modeli zararlı örneklerle yeniden eğitiyordu. 2024’te Arditi ve arkadaşları ret davranışının modelin içinde tek bir yönle temsil edildiğini ve bu yönün birkaç yüz prompt ile, eğitim yapmadan bulunup model ağırlıklarından silinebildiğini gösterdi (arXiv 2406.11717). Abliteration adı verilen bu yöntem sayesinde bugün yeni açık modellerin hizalaması kaldırılmış kopyaları birkaç gün içinde yayınlanıyor. Bu modeller hem saldırganların hem de red team ve zafiyet araştırması yapan ekiplerin araç setinde yer alıyor.
Bu yazıda önce ret davranışının modelin içinde nasıl temsil edildiğini, ardından ret yönünün nasıl bulunup model ağırlıklarından silindiğini anlatıyoruz. Sonra yöntemi uygularken dikkat edilmesi gereken noktalara, abliterated modellerin red team ve zafiyet araştırmasındaki kullanımına ve alandaki güncel gelişmelere değiniyoruz.
Residual stream ve ret yönü
Dil modelleri metni token adı verilen küçük parçalara böler. Örneğin “abliteration” kelimesi modelin sözlüğüne göre “abl”, “iter” ve “ation” gibi parçalara ayrılabilir. Model her token’ı bir sayı listesiyle, yani bir vektörle temsil eder. Yazı boyunca örnek olarak kullandığımız Qwen3-Next-80B’de bu liste 2048 sayıdan oluşur (d = 2048) ve model bu vektörü 48 katman boyunca adım adım günceller.
Residual stream, token’ın vektörünün katmanlar boyunca taşındığı hattır. Herhangi bir noktadaki değerine aktivasyon denir ve yazıda h ile gösterilir. Katmanlardaki bloklar h’yi baştan yazmaz, hesapladıkları sonucu son matrisleriyle çarpıp h’nin üzerine ekler. Bu eklemeler kelimenin anlamını bağlama göre değiştirir.
Aşağıdaki animasyon “Denizde yüz” cümlesindeki “yüz” token’ını izler. “Yüz” kelimesinin başlangıç vektörü sayı, surat ve yüzmek anlamlarının ortasındadır. Attention bloğu (cümledeki diğer token’lara bakan blok) “Denizde” kelimesinden gelen bilgiyi ekler ve vektör yüzmek anlamına kayar. MLP bloğu (token’ı tek başına işleyen blok) bu anlamı pekiştirir. Alttaki harita, 2048 sayıdan oluşan vektörün iki yöne düşen görünümüdür.
Kelimenin anlamı vektörün yönüyle ifade edildiği gibi, modelin bir isteği reddedip reddetmeyeceği de vektörde bir yönle temsil edilir. Arditi’nin incelediği 13 sohbet modelinin hepsinde aktivasyonun bu yöndeki bileşeni büyükse model reddediyor, küçükse yanıt veriyordu. Bu yöne ret yönü denir. Ret yönü aktivasyondan çıkarıldığında model zararlı isteklere yanıt veriyor, zararsız bir isteğe eklendiğinde ise ekmek tarifi gibi bir isteği bile reddediyor. Yani yön reddi doğrudan kontrol ediyor.
Abliteration bu yönü modelden siler. Residual stream’e sadece embedding matrisi ve blokların son matrisleri, yani attention bloğunun çıkış matrisi W_O ve MLP bloğunun çıkış matrisi W_down yazdığı için, bu matrisler ret yönüne hiçbir şey yazamayacak şekilde değiştirildiğinde ret yönü modelden kalıcı olarak kaybolur. Aşağıdaki bölümlerde önce yönün nasıl bulunduğunu, sonra nasıl silindiğini anlatıyoruz.
Yöntem
Ret yönünün bulunması
Bu bölümde yöntemi Arditi’nin orijinal çalışmasındaki haliyle anlatıyoruz. Ret yönü, zararlı ve zararsız iki prompt grubu modelden geçirilerek bulunur. Bu sırada model eğitilmez ve ağırlıklar değişmez, sadece her prompt için aktivasyonlar kaydedilir. Her katmanda iki grubun ortalama aktivasyonu alınır ve ret yönü bu iki ortalamanın farkından hesaplanır.
Aşağıdaki animasyonda her nokta bir prompt’un aktivasyonudur. “Ekmek tarifi” ve “şiir yaz” gibi zararsız prompt’lar bir bölgede, “zararlı yazılım yaz” ve “parola çal” gibi zararlı prompt’lar başka bir bölgede toplanır. İki grubun ortalaması ν ve μ alınır, aradaki fark r bulunur ve r uzunluğu 1 olacak şekilde ölçeklenerek ret yönü r̂ elde edilir. Animasyon iki boyutlu olsa da gerçek modelde r̂ çok daha uzun bir vektördür, örneğin Qwen3-Next-80B’de 2048 sayıdan oluşur. Arditi’nin yönteminde ortalamalar her katmanda ve modelin yanıtı başlamadan hemen önceki her token pozisyonunda ayrı hesaplanır, çünkü model reddedip reddetmeyeceğine bu token’larda karar verir. Her biri bir aday yön oluşturur ve bunlardan biri seçilir.
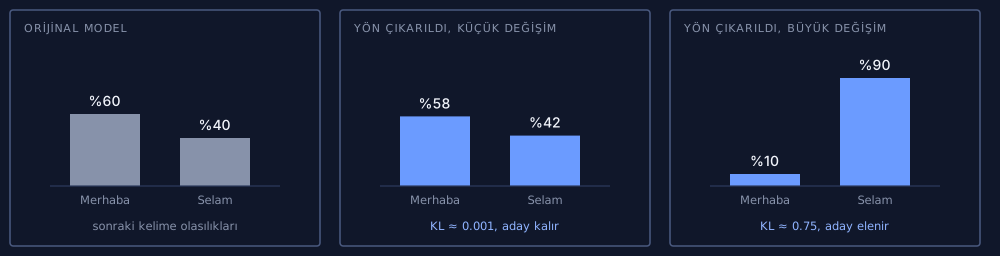
Adaylar arasından, çıkarıldığında reddi en çok azaltan, eklendiğinde ret oluşturan ve zararsız prompt’lardaki çıktıyı en az etkileyen yön seçilir. Çıktıdaki değişim, iki olasılık dağılımının ne kadar farklı olduğunu ölçen KL divergence ile ölçülür. Aşağıdaki şekilde küçük bir değişimde KL 0’a yakın kalıyor, büyük bir değişimde yükseliyor ve aday eleniyor.
Son katmanlardaki yönler doğrudan kelime seçimine çok yakın olduğu için ayrıca elenir. Arditi bu işlem için 128 zararlı ve 128 zararsız prompt kullandı. Eğitim yapılmadığı için işlem orta büyüklükteki bir modelde tipik olarak tek bir GPU’da dakikalar sürer.
Yönün aktivasyondan çıkarılması
Seçilen yön her katmanda aktivasyondan çıkarılır. İşlem, aktivasyonun ret yönündeki bileşenini (izdüşümünü) bulup bu kadarını geri çekmekten ibarettir. Geriye kalan vektör bu yönde hiçbir şey taşımaz, yöne dik bilgi ise olduğu gibi korunur.
Ters yöndeki müdahalede fark vektörü bir katmanda aktivasyona eklenir. Aşağıdaki animasyonda ret kararı, yön boyunca bir eşikle ayrılan iki bölge olarak basitleştirilmiştir. Yön çıkarıldığında iki grup ayırt edilemez hale gelir, yön eklendiğinde zararsız prompt’lar ret tarafına geçer.
Bu iki müdahale model çalışırken araya giren küçük bir kodla yapılır. Ağırlıklar değişmediği için geri alınabilir ve seçilen yönün doğru olup olmadığını test etmek için kullanılır.
Yönün ağırlıklardan silinmesi
Kalıcı abliteration aynı etkiyi residual stream’e yazan matrislere işler. Her yazıcı matris, ürettiği çıktının ret yönündeki kısmını baştan çıkaracak şekilde değiştirilir. Bu işleme weight orthogonalization, yani ağırlıkların ret yönüne dik hale getirilmesi denir.
Bir matrisin ne yaptığını görmek için her yönden uzunluğu 1 olan girdiler, yani uçları bir çember oluşturan vektörler matristen geçirilir. Matris vektörleri döndürüp birbirine dik iki yönde farklı oranlarda esnettiği için çember bir elipse dönüşür. Elips ret yönünde ne kadar uzanıyorsa, matris de çıktısına o kadar ret bileşeni ekleyebilir. Aşağıdaki animasyonda örnek matrisin elipsi ret yönü boyunca uzanıyor. Ortogonalizasyon bu yöndeki esnetmeyi sıfıra indirir, elips ret yönüne dik bir doğruya çöker ve çıktının ret yönündeki izdüşümü her girdi için sıfır olur.
Aynı durum yüksek boyutta da geçerlidir, çember yerine birim küre bir elipsoide dönüşür. Ortogonalizasyon bu elipsoidi sadece ret yönünde basar. Örneğin Qwen3-Next-80B’nin 2048 boyutlu uzayında elipsoit, ret yönüne dik 2047 boyutlu bir alt uzaya sığar.
Embedding matrisinde de her token’ın başlangıç vektöründen ret yönündeki kısım çıkarılır. Aktivasyon yazıcı matrislerin çıktılarının toplamı olduğu için hepsi değiştirildiğinde aktivasyonun ret yönündeki izdüşümü her katmanda sıfır kalır. Tek bir yön bütün yazıcı matrislere tam olarak uygulandığında sonuç, çalışma sırasında her katmanda yapılan çıkarma ile aynıdır. Mimari ve parametre sayısı değişmediği için abliterated model orijinaliyle aynı boyutta ve aynı hızda çalışır. Katman başına farklı yön kullanan veya embedding’i değiştirmeyen araçlarda (açık kaynak abliteration aracı Heretic gibi) bu eşdeğerlik tam sağlanmaz ve etkinin ne kadar yakın olduğu ancak ölçümle görülür.
Kısmi ve katmana göre değişen silme
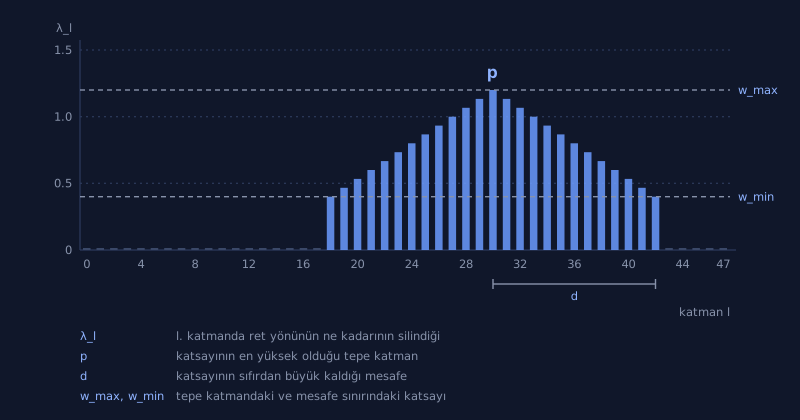
Tam silme bazı modellerde yetenek kaybına yol açtığı için uygulamada izdüşümün tamamı yerine λ katsayısı kadarı çıkarılır. Animasyonda λ = 1’de izdüşüm sıfırlanıyor, λ < 1’de kısmen kalıyor, λ > 1’de ise işareti ters dönüyor ve aktivasyon ret yönünün tersine itiliyor. Bu, reddi daha güçlü bastırmak için kullanılır ve Heretic en yüksek katsayıyı 1,5’e kadar arar.
Katsayı her katmanda farklı olabilir. Heretic, katsayıyı bir tepe katmanında en yüksek tutar ve ondan uzaklaştıkça azaltır. Tepe katmanın yeri, en yüksek değer ve kullanılacak yön, zararlı prompt’lardaki ret sayısını ve zararsız prompt’lardaki çıktı değişimini birlikte azaltacak şekilde otomatik olarak aranır. Heretic’in kodundaki notlara göre reddi kaldırmak için attention bloğunu değiştirmek çoğu zaman yeterlidir, MLP’ye dokunmak ise daha fazla yetenek kaybına yol açar. Aşağıdaki şekil 48 katmanlı Qwen3-Next-80B için temsili bir dağılımı gösterir.
Tek yönün ötesi
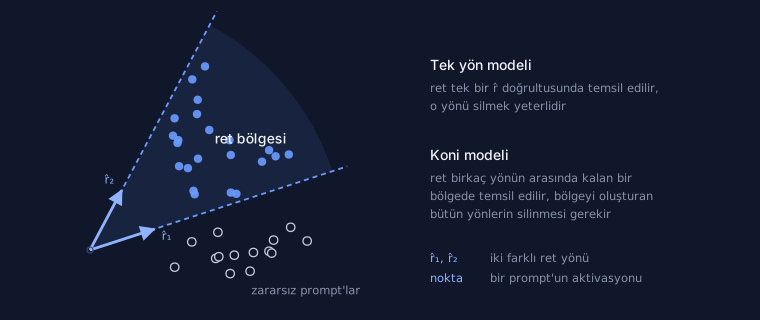
Tek yön varsayımı zararlı ve zararsız istekleri ayırmak için büyük ölçüde işe yarar ama ret davranışının tamamını açıklamaz. Ret, birkaç yönün arasında kalan, koni şeklinde bir bölgede de temsil edilebilir (arXiv 2502.17420). Bu durumda bir yönü silmek yetmez, bölgeyi oluşturan bütün yönlerin silinmesi gerekir.
Bir çalışmaya göre farklı ret türleri (zararlı içerik, eksik istek gibi) farklı yönlere karşılık gelir, ama bu yönler modelin ret verip vermediğinden çok nasıl ret verdiğini belirler (arXiv 2602.02132). Başka bir çalışmada trilyon parametreli modellerde reddin çok sayıda yöne ve katmana dağıldığı görüldü. Bu modellerde belirli bir alandaki reddi hedefleyen abliteration da yapılabiliyor, örneğin 1T parametreli Kimi K2’de sadece siber güvenlik konularındaki ret kaldırıldı (arXiv 2607.02714).
MoE ve hibrit mimari
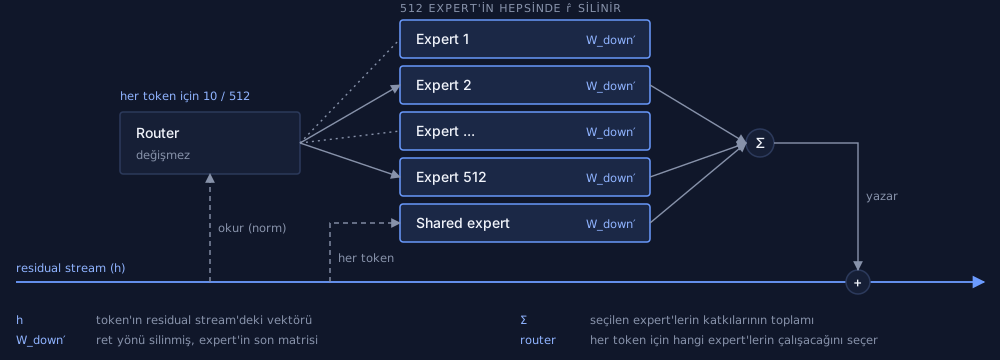
Şimdiye kadar her katmanda tek bir MLP bloğu olduğunu varsaydık. Oysa büyük açık modellerin çoğu, örneklerde kullandığımız Qwen3-Next-80B de dahil, MoE (Mixture of Experts) mimarisini kullanır ve bu, ret yönünün silinmesi gereken matris sayısını çok artırır. MoE modellerde her katmanda tek bir MLP yerine expert adı verilen çok sayıda küçük MLP bulunur, Qwen3-Next-80B’de bu sayı 512’dir. Router adlı bir ağ her token için bunlardan 10’unu seçer ve yanlarına her zaman çalışan bir shared expert eklenir. Seçim token’a göre değiştiği için art arda gelen iki token tamamen farklı expert’lere gidebilir. Sadece seçilen expert’ler çalıştığından modelin 80B parametresinin yaklaşık 3B’si bir token için kullanılır.
Her expert’in down_proj matrisi residual stream’e yazdığı için ortogonalizasyon, seçilip seçilmediğine bakılmadan 512 expert’in hepsine ve shared expert’e uygulanır. Aksi halde router’ın seçtiği değiştirilmemiş bir expert ret yönünü geri yazar. Router residual stream’e yazmadığı için değiştirilmez.
Qwen3-Next ayrıca hibrit bir mimari kullanır. 48 katmanın 36’sında klasik attention yerine uzun metinlerde daha az hesap yapan linear attention (Gated DeltaNet) bloğu bulunur ve bunun son matrisi de residual stream’e yazar. Yön 48 katmanın hepsine uygulanırsa Qwen3-Next-80B’de katman başına 514, toplamda yaklaşık 24.700 matris değişir. Heretic gibi araçlar ise yönü çoğu zaman sadece bir katman aralığına uygular.
Hazır abliterated modellerde hangi katmanların değiştirildiği genellikle belirtilmez. Hugging Face’te açık modellerin abliterated sürümlerini düzenli olarak yayınlayan huihui-ai’nin GLM-5.3 sürümü bu konuda açık bir örnek. Bu sürüm bir yama dosyası olarak dağıtılıyor ve modeli indiren kişi, yamayı uygularken hangi katman aralığının ve hangi matrislerin değiştirileceğini kendisi seçiyor. Model sayfasındaki tabloya göre sadece attention matrisleri değiştirildiğinde model cevabına hâlâ uyarılar ekliyor, shared expert’in son matrisi de eklendiğinde uyarılar azalıyor, bütün expert’ler eklendiğinde ise kalkıyor (model sayfası). Yani attention’ı değiştirmek reddi kaldırmaya çoğu zaman yetse de, modelin cevaba eklediği çekinceleri silmek için MLP tarafına da dokunmak gerekebiliyor.
Uygulama
Abliteration’ın uygulanması aşağıdaki akışla ilerler.
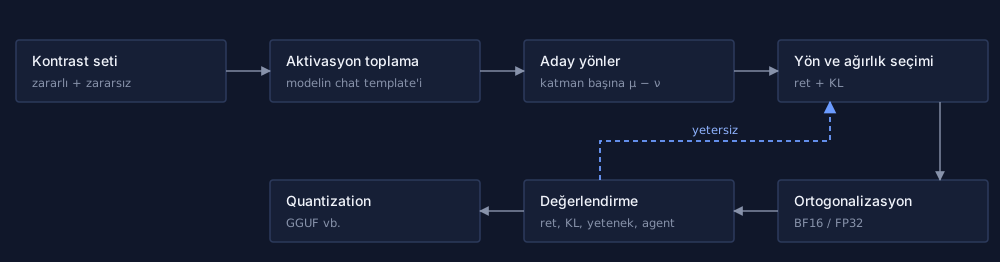
Akışın ilk adımları Hugging Face Transformers ile birkaç satırda yazılabilir. Örnek kod, Qwen3-Next-80B’de ret yönünü tek bir katmandan hesaplar ve residual stream’e yazan bütün matrislerden siler. Kodda W_O, Qwen’deki adıyla o_proj (linear attention katmanlarında out_proj), W_down ise down_proj olarak geçer.
# Verilen prompt'ların, belirtilen katmandaki ortalama aktivasyonunu döndürür
@torch.no_grad()
def mean_act(prompts, layer):
    acts = []
    for p in prompts:
        # Prompt'u chat template'le biçimlendir, sonuna yanıtın başlangıç işaretini ekle
        ids = tok.apply_chat_template(
            [{"role": "user", "content": p}],
            add_generation_prompt=True, return_tensors="pt",
        ).to(model.device)
        # Modeli bir kez çalıştır ve bütün katmanların aktivasyonlarını al
        hs = model(ids, output_hidden_states=True).hidden_states
        # Yanıttan önceki son token'ın bu katmandaki aktivasyonunu sakla
        acts.append(hs[layer][0, -1].float())
    return torch.stack(acts).mean(0)

# Yönü modelin ortasına yakın bir katmandan al (48 katmanlı modelde 28. katman)
L = int(0.6 * model.config.num_hidden_layers)

# Ret yönü zararlı ve zararsız ortalamaların farkıdır, uzunluğu 1'e ölçeklenir
r_hat = mean_act(harmful, L) - mean_act(harmless, L)
r_hat /= r_hat.norm()

# Bir matrisin çıktısından ret yönündeki kısmı siler (lam = 1 tamamen, lam < 1 kısmen)
@torch.no_grad()
def orthogonalize(linear, v, lam=1.0):
    # Matrisin her sütunu residual stream'e yazılan 2048 sayılık bir vektördür
    W = linear.weight.data.float()
    v = v.to(W.device)
    # Her sütundan ret yönündeki izdüşümü çıkar
    W -= lam * torch.outer(v, v @ W)
    linear.weight.data = W.to(linear.weight.dtype)

# Bir katmanda residual stream'e yazan bütün matrisleri sırayla döndürür
def writers(layer):
    # 48 katmanın 36'sında linear attention, 12'sinde klasik attention var
    if hasattr(layer, "linear_attn"):
        yield layer.linear_attn.out_proj
    else:
        yield layer.self_attn.o_proj
    # MoE bloğunda 512 expert'in ve shared expert'in son matrisleri
    yield from (e.down_proj for e in layer.mlp.experts)
    yield layer.mlp.shared_expert.down_proj

# Ret yönünü bütün katmanlardaki bütün yazıcı matrislerden sil
for layer in model.model.layers:
    for m in writers(layer):
        orthogonalize(m, r_hat)

# Embedding matrisinin her satırı bir token'ın başlangıç vektörüdür
# Her satırdan ret yönündeki kısmı çıkar
emb = model.model.embed_tokens
E = emb.weight.data.float()
v = r_hat.to(E.device)
E -= torch.outer(E @ v, v)
emb.weight.data = E.to(emb.weight.dtype)
Sonucu belirleyen kritik noktalar aşağıdaki gibidir.
- Prompt setleri: Bir prompt’un aktivasyonu hem konusunu hem de isteğin zararlı olup olmadığına dair bir sinyal taşır. Aynı konudaki zararlı ve zararsız prompt’lar eşleştirildiğinde, örneğin “bir web sitesine nasıl sızarım” ile “web sitemin güvenliğini nasıl test ederim” yan yana konduğunda, ortalamaların farkında konu bilgisi birbirini götürür. Ancak hassas bir konudaki zararsız prompt da modelde zarar sinyali uyandırdığı için geriye kalan fark çok küçük olur ve bulunan yön reddi kaldıramaz (arXiv 2603.22061). Bu yüzden zararsız prompt’lar genel bir havuzdan seçilir. Zararlı prompt’lar ise hedeflenen alanı temsil etmelidir, çünkü farklı alanlardaki ret farklı yönlere dağılabilir.
- Chat template: Konuşmayı modelin eğitimde gördüğü özel işaretlerle biçimlendiren şablondur (Qwen’de kullanıcı mesajı
<|im_start|>userile başlar). Aktivasyonlar modelin gerçek şablonu ve kullanılacak system prompt ile toplanmalıdır. Aksi halde bulunan yön, modelin çalışırken gördüğü girdiyi temsil etmez. - Sayı hassasiyeti: Ortogonalizasyon, ağırlıklar 16 veya 32 bitlik sayılarla (BF16, FP32) tutulurken yapılır. Ağırlıkların 4 veya 8 bite sıkıştırılması, yani quantization, en sona bırakılır. 4 bitte her ağırlık 16 farklı değerden en yakınına yuvarlanır ve örneğin 0,4132 gibi bir değer 0,4375’e dönebilir. Bu yuvarlama silinen izdüşümü tam sıfır bırakmadığı için etki quantize edilmiş dosyada yeniden ölçülür. Aynı nedenle 4-bit bir GGUF dosyası (llama.cpp’nin kullandığı model formatı) doğrudan düzenlenmez.
- Değerlendirme: Ret oranı “I cannot” gibi kalıpları aramakla değil, yanıtları sınıflandıran ayrı bir modelle ve her prompt birden fazla kez denenerek ölçülür. Yetenek kaybı için GSM8K (ilkokul düzeyi matematik problemleri) ve MMLU (birçok alanda çoktan seçmeli sorular) gibi testler çalıştırılır. 16 modeli kapsayan bir karşılaştırmada en hassas yetenek matematik çıktı ve GSM8K skoru araca ve mimariye göre 18,81 puana kadar düştü (arXiv 2512.13655). Tool kullanan agent’larda ret mekanizması sohbetten farklı çalıştığı için ölçüm agent senaryosunda ayrıca yapılır (arXiv 2609.35117).
Güvenlik çalışmalarında kullanımı
Meşru kullanımların çoğu, modelin kendi reddinin işin önünde durduğu durumlardır. Aşağıdaki şekil bunların en yaygını olan guardrail testinin akışını gösterir.
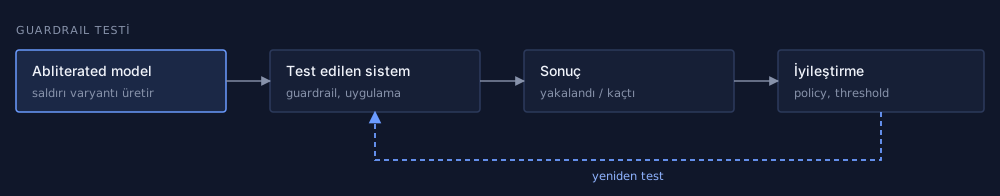
- Guardrail ve red team testleri: Bir guardrail’i veya prompt injection savunmasını denerken saldırı içeriğini üretecek modelin kendi reddi araya girmemelidir. Abliterated model jailbreak ve prompt injection varyantlarını filtrelenmeden üretir, sistemin bunların hangilerini yakaladığı ölçülür.
- Zafiyet analizi ve PoC: Hizalanmış modeller yetkili bağlamda bile istismar ve PoC isteklerini sık reddediyor. Aynı soydan gelen hizalanmış ve abliterated Gemma modellerinin Java zafiyet onarımında karşılaştırıldığı bir çalışmada kullanılabilir yama oranı %29,9’dan %67,8’e, derlenen yama oranı %9,0’dan %32,8’e çıktı (arXiv 2607.05842). Abliteration modele yeni bilgi eklemez, kazanç modelin ret yüzünden kullanamadığı yetenekten gelir.
- Aşırı reddin azaltılması: Hizalanmış modeller zararsız ama hassas görünen istekleri de reddedebilir. Bir ilacın yüksek dozdaki yan etkilerini soran bir eczacı veya kendi sunucusundaki açık portları soran bir sistem yöneticisi bu duruma örnektir. Sadece bu hatalı ret bileşenini silip gerçek güvenlik retlerini koruyan bir varyant da var (arXiv 2410.03415).
- Savunma araştırması: Ret yönündeki izdüşüm, model çalışırken bir zarar sinyali olarak izlenebilir. Ret yönünü ortaya koyan çalışma, prompt’un sonuna eklenen ve otomatik aramayla bulunan anlamsız görünen token dizilerinin (GCG adversarial suffix) bu izdüşümü bastırarak reddi atlattığını da gösterdi (arXiv 2406.11717).
Modelin reddinin ortadan kalkması saldırganların da işine yarar. Yerelde çalışan abliterated bir model phishing metni veya zararlı kod üretirken ne ret verir ne de bir sağlayıcının kötüye kullanım izlemesine takılır.
Güncel durum
Abliteration, tek bir makaleye dayanan bir teknik olmaktan çıkıp araçları, ticari kullanımı ve karşı önlemleri olan bir alana dönüştü.
- Araçlar: Heretic’in 2.x sürümlerinde varsayılan yöntem ARA (Arbitrary-Rank Ablation). ARA tek bir yön çıkarmak yerine, değiştirilecek katmanların girdi ve çıktılarına bakarak zararsız prompt’lardaki davranışı koruyan ve zararlılardakini değiştiren bir güncelleme arar. Makalesi henüz yayınlanmadı. Klasik yönlü abliteration da araçta seçenek olarak duruyor.
- Büyük modellerde maliyet: Anthropic’in GLM-5.3 raporuna göre abliteration bu modelde reddetme oranını JailbreakBench ve HarmBench’te %90’ın üzerinden yaklaşık %3 ve %2’ye indirdi, modelin yeteneklerini ise belirgin şekilde düşürmedi. Anthropic ekibi bu iş için yaklaşık 2.200 GPU saati harcadı ve sıfırdan başlayan bir ekip için gereken süreyi 600 GPU saati civarında tahmin ediyor (Anthropic).
- Topluluk sürümleri: Yeni bir açık model yayınlandığında abliterated sürümü genelde birkaç gün içinde Hugging Face’te çıkıyor. Bunu düzenli yapan huihui-ai’nin listesinde 140’tan fazla abliterated model var. Çoğu Qwen ve Gemma tabanlı, son eklenenler arasında GLM-5.3 ve DeepSeek-V4.1-Flash sürümleri de bulunuyor.
- Ticari kullanım: Bazı şirketler bu büyük açık modellerin abliterated sürümlerini red team ve saldırı simülasyonu için API üzerinden sunmaya başladı (TechCrunch). Ağırlıklar paylaşılmadığı için bu modellerde hangi değişikliğin yapıldığı dışarıdan doğrulanamıyor.
- Yön bulma: Yeni yöntemler, bütün zararlı prompt’ları tek bir ortalamada toplamak yerine her prompt için ayrı bir yön çıkarıp bunları öğrenilmiş ağırlıklarla birleştiriyor ve tek ortalamadan daha etkili bir yön elde ediyor (arXiv 2610.29555).
- Abliteration’ın sınırları: Reddin kalkması modelin tarafsızlaştığı anlamına gelmiyor. Tayvan hakkındaki sorularla yapılan bir testte modellerin cevabını abliteration’dan çok, sorunun geleneksel ya da basitleştirilmiş Çince karakterlerle sorulması belirledi (arXiv 2610.29342).
- Karşı önlemler: Ret yönünün ortalamalar farkıyla bulunmasını yanıltan ve modeli yeniden eğitmeden uygulanabilen ağırlık düzenlemeleri öne çıkıyor. Bu yaklaşımı deneyen bir çalışmada Heretic ile yapılan saldırının başarı oranı %88,7’den %18’e indi (arXiv 2609.16204).
Açık ağırlıklı bir modelin hizalaması, model dosyasına erişimi olan biri için bir güvenlik kontrolü değil, kaldırılabilen bir varsayılan davranıştır. Abliterated modeller red team, zafiyet araştırması ve guardrail testleri için değerli araçlardır. Ancak bu modellerle çalışan bir sistemde koruma, modelin dışındaki önlemlere dayanmak zorundadır.
Yeni yazılardan haberdar ol
Yeni bir yazı yayınlandığında e-posta ile haber verelim.
Adresin yalnızca yeni yazı bildirimleri için kullanılır. Her mailin altındaki linkle istediğin zaman abonelikten çıkabilirsin.